使用CRC调查错误检测
此示例检查循环冗余校验(CRC)如何检测错误,当传输数据包在一个噪声二进制信道时。 AnyMath模型传输随机数据包,向其添加CRC验证位,在二进制对称信道中扭曲它们,检查接收时的状态,并计数正确的,检测到的和未检测到的错误数据包。 该模型由AnyMath库块组装而成,包括通用CRC发生器和通用CRC综合征检测器。 该脚本以编程方式管理模型,并将仿真结果与从代码的权重谱计算出的精确理论进行比较。 实验也可以在基于Genie框架的web应用程序中设置,该应用程序运行相同的模型。 该示例对于研究通信信道的噪声容忍编码和统计建模的工程师和学生非常有用。
在任何通信信道中,一些比特被干扰失真。 为了使接收器知道错误,发送器向数据添加冗余校验位。 CRC是这种验证的最常用方法之一:它用于以太网,USB,工业网络协议,文件存档和数据存储。
CRC仅检测错误,但不纠正它们。 接收器丢弃错误分组或再次请求。 因此,CRC质量的主要指标是错误被忽视的概率。
在这个例子中,我们:
- 让我们简要分析CRC理论,并推导出三个数据包接收结果的确切概率。
- 让我们研究模型并用预先知道的答案在实验中进行测试。
- 让我们在很宽的误差概率范围内将仿真结果与理论进行比较。
- 让我们启动一个web应用程序,其中无需编程即可执行实验。
CRC理论
分组的比特被认为是字段GF(2)上多项式的系数,其中加法是排他性的或。 信息位 形成多项式 度少 . 生成多项式 学位 度列表设置: [5, 3, 0] 手段 .
CRC编码器将除法的余数分配给数据:
完整包装长度 ,在初始设置 , , . 任何代码字 分为 无影无踪。
接收器计算综合征,这是除以接收到的字的余数 . 如果信道已添加错误向量 ,该综合征等于 . 只有在以下情况下才会检测到错误 它本身是非零的码字。
二进制对称信道独立地以概率反转每个比特 . 每个包正好属于三个类中的一个:
哪里 -权重代码字的数量 码的权重范围)。 由 全部 误差向量的可能性相等,未检测到的误差的比例为 :来自 对于具有零综合征的向量,有必要排除唯一没有错误的情况。 为 和 差不多了 .
模型描述
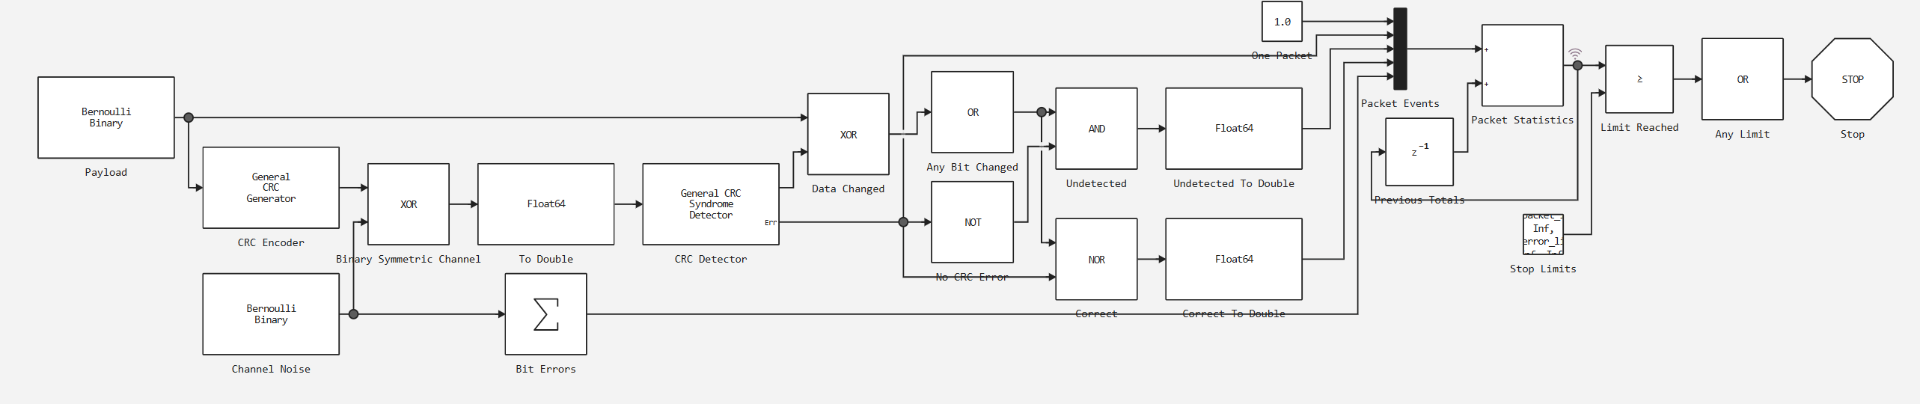
模型 crc_error_detection.engee 它仅从AnyMath库块编译,并以固定步骤工作。 . 一步是一个数据包,所以模拟时间意味着数据包编号,而不是物理时间。
| 结 | 工程师座 | 委任事宜 |
|---|---|---|
| 数据来源 | 伯努利二进制生成器 Payload |
每个步骤的随机信息位 |
| 编码器 | 通用CRC生成器 CRC Encoder |
增加 验证位 |
| 频道 | 伯努利二进制生成器 Channel Noise,逻辑运算符异或 Binary Symmetric Channel |
概率为1的误差向量 加起来是XOR代码字 |
| 探测器 | 数据类型转换 To Double,一般CRC综合征检测器 CRC Detector |
突出显示信息位和非零综合征的标志 |
| 错误处理 | 逻辑运算符(XOR,OR,NOT,AND,NOR),元素之和,Mux,数据类型转换 | 生成包的事件向量 |
| 柜台 | 添加 Packet Statistics 和单位延迟 Previous Totals |
累积事件 |
| 停止 | 常量,关系运算符,逻辑运算符或,停止模拟 | 模型被限制停止 |
错误处理节点在每一步生成分组事件向量。:
哪里 -非零综合征的标志, —至少一个信息位已改变的标志。 向量元素意味着:已经传输了一个分组,已经检测到一个错误,已经错过了一个错误,分组是正确的,以及反转比特的数量。 加法器,加法器 Packet Statistics 与延迟单元一起 Previous Totals 累积五个计数器的事件向量。
注意"包是正确的"类:它要求信息位没有改变,综合征为零。 只有校验位中的错误会产生非零综合症,并被视为检测到-接收器无法将其与数据中的错误区分开来。
块参数是工作区的变量 crc_n, crc_k, crc_p, crc_seed, crc_packet_limit 和 crc_error_limit. 它们在每次启动之前由脚本代码设置。 可以使用脚本重现该模型。 resources/julia/build_model.jl.
块参数
让我们从连接模型管理功能 resources/julia/crc_runtime.jl 和多项式的目录,打开模型并用命令输出关键块的主要参数 engee.get_param. 所有路径都是从脚本文件夹通过 @__DIR__.
using JSON3, Printf, Plots
gr()

resources_dir = joinpath(@__DIR__, "resources")
include(joinpath(resources_dir, "julia", "crc_runtime.jl"))
include(joinpath(resources_dir, "julia", "polynomials.jl"))
crc_open_model()

show_params = Dict(
    "Payload" => ["SamplesPerFrame", "ProbabilityOfZero", "InitialSeed", "SampleTime"],
    "CRC Encoder" => ["GeneratorPolynomial", "InitialStates", "DirectMethod", "ReflectInputBytes", "FinalXOR"],
    "Channel Noise" => ["SamplesPerFrame", "ProbabilityOfZero", "InitialSeed", "SampleTime"],
    "Binary Symmetric Channel" => ["Operator"],
    "CRC Detector" => ["GeneratorPolynomial", "InitialStates", "DirectMethod"],
    "Data Changed" => ["Operator"], "Any Bit Changed" => ["Operator", "Inputs"],
    "Undetected" => ["Operator"], "Correct" => ["Operator"],
    "Previous Totals" => ["InitialCondition", "SampleTime"],
    "Stop Limits" => ["Value"], "Limit Reached" => ["Operator"])
for b in ["Payload", "CRC Encoder", "Channel Noise", "Binary Symmetric Channel", "CRC Detector", "Data Changed",
          "Any Bit Changed", "Undetected", "Correct", "Previous Totals", "Stop Limits", "Limit Reached"]
    prm = engee.get_param("crc_error_detection/" * b)
    println(rpad(b, 26), prm["BlockPath"])
    println(" "^26, join(["$k = $(prm[k])" for k in show_params[b]], "; "))
end
参数由工作区变量设置。 源的步骤等于 和 通过一个位,因此,每个模型步骤,每个源输出一帧从 或 比特。 CRC参数对应于经典方案:零初始状态,没有直接方法,位反射和最终异或。 第二、第四和第五计数器的停止阈值为 换句话说,它们不影响停止。
多项式手册
档案 polynomials.jl 它包含一个生成循环Bose—Chowdhury—Hockingham码(BCH)多项式的表。 对于每一行,计算模型格式的度数列表和支持的特征:CRC AnyMath块是否支持多项式。 让我们打印表格。
println(rpad("n", 5), rpad("k", 5), rpad("t", 5), rpad("工程师座", 13), "多项式(度)")
for x in crc_presets
    println(rpad(x.n, 5), rpad(x.k, 5), rpad(x.t, 5), rpad(x.supported ? "是的" : "非也。", 13), x.poly)
end
@printf("Поддерживается %d из %d полиномов\n", count(x -> x.supported, crc_presets), length(crc_presets))
专栏 -相应的BCH代码将纠正的错误数。 模型只检测错误,所以 提供作为参考。 所有长度代码都可用 , 和 和五个长度代码 . 六个长度代码 度的多项式从 以前 不支持CRC库块:它们的程度更大 .
检查模型
档案 crc_runtime.jl 它包含六个功能:
crc_validate检查经验的参数:块长度,概率,多项式的度数列表,限制和种子;crc_poly_literal将多项式的度数向量写入CRC块的文字;crc_open_model如果模型尚未打开,则加载该模型。;crc_signal在仿真结果中找到记录的块信号;crc_run_json接受参数作为JSON字符串,将它们写入工作区变量和CRC块参数,并使用命令运行模型engee.run并将总计数器返回为JSON;crc_reference_encode-独立CRC编码器:将多项式"分成列"以检查通用CRC生成器块。
选择JSON格式是因为web应用程序使用相同的函数。 让我们开始一个控制实验: , ,多项式 [5, 3, 0], 包裹。
crc_example_config = Dict("n" => 19, "p" => 0.1, "poly" => [5, 3, 0],
                          "blocksToStop" => 2000, "errorsToStop" => 2000, "seed" => 12345)
crc_example_result = JSON3.read(crc_run_json(JSON3.write(crc_example_config)))
@printf("Всего %d: верно %d, обнаружено %d, не обнаружено %d; битовых ошибок %d; %s; %.1f с\n",
        crc_example_result.packets, crc_example_result.correct, crc_example_result.detected,
        crc_example_result.undetected, crc_example_result.bit_errors, crc_example_result.stop_reason,
        crc_example_result.seconds)
@assert crc_example_result.correct + crc_example_result.detected + crc_example_result.undetected == crc_example_result.packets
背后 包裹在 正确接受 包裹, 检测到错误的包装和 跳过了。 这是数据包的数量,而不是位:通道已反转。 位从 这就是 , 在预期条件下 . 正确包的百分比 与理论上的不谋而合 . 三类之和等于传输数据包的数量。 此检查由 @assert.
现在让我们进行一组对照实验。 档案 verify_model.jl 使用预先已知的答案在六个实验中运行模型,并验证无效参数是否被拒绝。 其中检查是通用CRC生成器块的输出与独立编码器的比较 crc_reference_encode 上 模型的真实包和检查任何单个错误给出非零综合症。 结果写在 resources/data/verification.json.
verification = JSON3.read(include(joinpath(resources_dir, "julia", "verify_model.jl")))
println("所有检查已完成: ", verification.passed)
for t in verification.tests
    if haskey(t, :result)
        r = t.result
        @printf("  %-48s n=%-3d p=%-4g пакетов %-5d верно %-5d обн. %-5d не обн. %d\n",
                t.case, r.n, r.p, r.packets, r.correct, r.detected, r.undetected)
    else
        @printf("  %-48s кадров %d, одиночных ошибок %d\n", t.case, t.frames, t.single_bit_cases)
    end
end
所有检查已完成:
-一切都很安静 包裹被正确接受了;
-守则 所有位的反转将一个代码字变成另一个代码字:七个单位的一个字被分成 . CRC没有看到这样的错误,并且Stop Simulation块恰好在之后停止模型 未检测到的错误;
-长度 总是找到相同的反转;
-相同的种子再现所有计数器;
-通用CRC发生器块的输出与所有独立编码器一致 在包装中,仅此而已 单一错误给出非零综合症。 这意味着库单元完全根据理论部分的公式计算CRC。;
-支持度最大的多项式 从表中,它的工作原理没有错误,和程度的多项式 在模型启动之前被拒绝。
与理论的比较
计算代码的确切权重范围 用多项式 . 为此,我们将使用参考编码器对所有内容进行编码。 让我们找到信息词并计算代码词的权重。 功能 theory 基于频谱,它计算三类包的概率。
poly = [5, 3, 0]; n_c, k_c = 19, 14
A = zeros(Int, n_c + 1)                          # A[w+1]为权重w的码字个数
for m in 0:2^k_c-1
    payload = [(m >> (k_c - i)) & 1 for i in 1:k_c]
    A[count(==(1), crc_reference_encode(payload, poly))+1] += 1
end
println("权重谱A_w(w:字数): ", join(["$(w):$(A[w+1])" for w in 0:n_c if A[w+1] > 0], "  "))
@printf("Минимальный ненулевой вес d_min = %d\n", findfirst(>(0), A[2:end]))

theory(p) = begin
    pc = (1 - p)^n_c
    pu = sum(A[w+1] * p^w * (1 - p)^(n_c - w) for w in 1:n_c)
    (correct = pc, undetected = pu, detected = 1 - pc - pu)
end
非零码字的最小权重 因此,CRC保证检测到任何单错误和双错误。 奇数权重的词有很多:一个多项式 不包含乘数 因此,与许多标准CRCs,例如CRC-16不同,它不检测奇数倍性的所有错误。 任何长度不超过的错误数据包 位被检测到:这样的错误向量不可被整除 .
让我们运行一个模型,用于从 以前 ,由 每个点上的包,并将三类包的份额与理论进行比较。
ps = [0.001, 0.003, 0.01, 0.03, 0.1, 0.2, 0.3, 0.5]
sim = Dict{Float64, Any}()
for p in ps
    cfg = Dict("n" => 19, "p" => p, "poly" => poly, "blocksToStop" => 20000, "errorsToStop" => 1_000_000, "seed" => 777)
    sim[p] = JSON3.read(crc_run_json(JSON3.write(cfg)))
    th = theory(p); r = sim[p]
    @printf("p = %-5g верно %.4f (теор. %.4f)  обн. %.4f (%.4f)  не обн. %.2e (%.2e)\n", p,
            r.correct / r.packets, th.correct, r.detected / r.packets, th.detected,
            r.undetected / r.packets, th.undetected)
end
正确和检测到的数据包的比例与理论在整个范围内的第二或第三位数字相匹配。 未检测到的错误是一个罕见的事件,并与小 该模型还没有注册任何。 要了解这是否与理论一致,我们需要估计统计误差。
让我们建立两个面板:正确和检测到的包在规则尺度上的比例,然后是未检测到的错误在对数尺度上的比例。 对于每个非零估计,我们将显示95%的Wilson置信区间。 为股份 它的边界
如果模型尚未注册事件,而不是对数尺度上的零值,我们将用三角形显示95%概率上限。 这样的三角形不是测量的分数。 一条水平线 不要画:价值 仅适用于 ,而不是整个范围 .
# 理论概率由精确的权重谱a_w计算。
pgrid = 10 .^ range(-3, log10(0.5); length = 200)

function wilson95(k, n)
    z = 1.959963984540054
    q = k / n
    den = 1 + z^2 / n
    mid = (q + z^2 / (2n)) / den
    half = z * sqrt(q * (1 - q) / n + z^2 / (4n^2)) / den
    (max(0.0, mid - half), min(1.0, mid + half))
end

main_plot = plot(pgrid, [theory(p).correct for p in pgrid];
    color = :seagreen, lw = 2, label = "没错,理论上", xscale = :log10,
    ylims = (-0.03, 1.05), ylabel = "包的份额",
    title = "CRC x^5+x^3+1,n=19:模型和精确理论",
    legend = :outertopright, left_margin = 5Plots.mm)
plot!(main_plot, pgrid, [theory(p).detected for p in pgrid];
    color = :royalblue, lw = 2, label = "发现的,理论的")
scatter!(main_plot, ps, [sim[p].correct / sim[p].packets for p in ps];
    color = :seagreen, marker = :circle, ms = 6, label = "没错,模特")
scatter!(main_plot, ps, [sim[p].detected / sim[p].packets for p in ps];
    color = :royalblue, marker = :square, ms = 6, label = "检测到,模型")

rare_plot = plot(pgrid, [theory(p).undetected for p in pgrid];
    color = :orangered, lw = 2, label = "未检测到,理论",
    xscale = :log10, yscale = :log10, ylims = (1e-8, 0.1),
    xlabel = "P位的反转概率", ylabel = "包的份额",
    legend = :outertopright, left_margin = 5Plots.mm)
nonzero_ps = [p for p in ps if sim[p].undetected > 0]
zero_ps = [p for p in ps if sim[p].undetected == 0]
for (j, p) in enumerate(nonzero_ps)
    r = sim[p]
    low, high = wilson95(r.undetected, r.packets)
    plot!(rare_plot, [p, p], [low, high]; color = :orangered, lw = 2,
        label = j == 1 ? "95% интервал Уилсона" : "")
end
scatter!(rare_plot, nonzero_ps,
    [sim[p].undetected / sim[p].packets for p in nonzero_ps];
    color = :orangered, marker = :diamond, ms = 6, label = "未检测到,模型")
scatter!(rare_plot, zero_ps,
    [wilson95(0, sim[p].packets)[2] for p in zero_ps];
    color = :orangered, marker = :dtriangle, ms = 7,
    label = "0活动:上限95%")

println("内的事件份额预计会有95%的间隔")
for p in ps
    r = sim[p]
    low, high = wilson95(r.undetected, r.packets)
    expected = r.packets * theory(p).undetected
    @printf("%-7g %6d    %7.3f    [%.3g, %.3g]       %s\n",
        p, r.undetected, expected, low, high,
        low <= theory(p).undetected <= high ? "да" : "нет")
end
@assert all(p -> begin
    r = sim[p]
    low, high = wilson95(r.undetected, r.packets)
    low <= theory(p).undetected <= high
end, ps)

plot(main_plot, rare_plot; layout = (2, 1), size = (1050, 760))
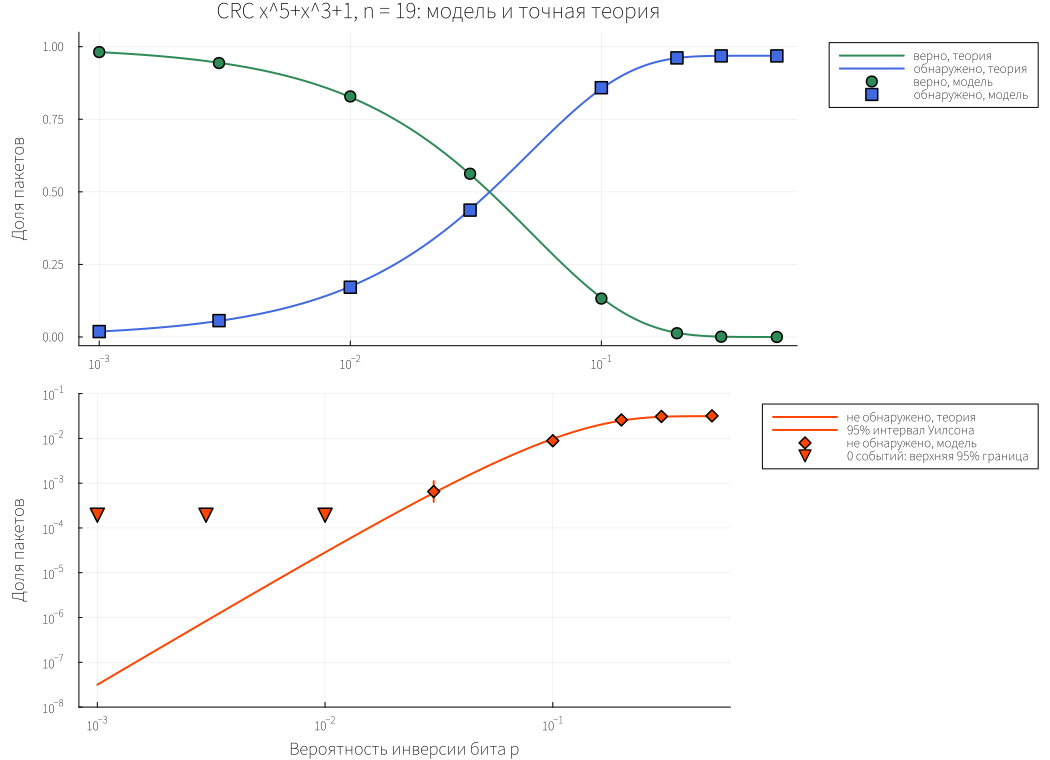
该模型与统计误差范围内的确切理论一致。 上面的面板显示了正确和检测到的数据包的匹配。 在下面的面板中,非零估计值周围的间隔包含一条理论曲线,该表确认了所有八个点的这一点。
由 , 和 确切的理论相应地期望 , 和 来自 . 在得到零事件的概率 作曲 . 因此,零计数器不矛盾的理论:对于这样的 需要更多的软件包。
由 模型给出了 反对理论 (关于 预期事件)。 不确定性区间包括理论值。 由 确切的价值 ,模型给出了关于 .
基于Genie框架的Web应用
Genie Framework—一组用于创建web应用程序的软件包:
Genie.jl-具有查询路由,HTML和JSON输出的web服务器;Stipple.jl-将脚本变量绑定到页面元素的响应式接口;GenieFramework.jl-一个共同的包,连接一切一次,并给出了一个宏@genietools.
工程师在云中启动精灵应用程序:团队 engee.genie.start(папка) 从文件中提升服务器 app.jl 指定的文件夹中并返回页面地址。 应用程序代码在单独的进程中执行。 要在加载模型的主AnyMath会话中执行命令,请使用函数 engee.genie.eval(строка_кода).
此示例的应用程序在文件夹中 resources/CRCApp:
index.html-具有经验参数字段的页面:块大小,错误概率,多项式,停止限制和种子。 按钮启动体验,清除历史记录,并上传CSV。 历史记录存储在sessionStorage浏览器选项卡。- 路线
/在app.jl给出这个页面,因为它是。 该接口是用纯JavaScript编写的,因此这里不需要点点滴滴反应式模型。 - 路线
POST /api/run接受JSON中的参数,并使用函数检查每个字段validate_request. 然后他打电话engee.genie.eval("crc_run_json(...)"):模型在主会话中启动,计数器返回到页面。 - 阻塞;阻塞
ReentrantLock它不允许您在第一个运行时启动第二个体验。 - 用户输入永远不会作为代码执行:只有经过验证的JSON字符串作为字符串文字传递到主会话。
应用程序中表的每一行都是实际模型启动的结果。 crc_error_detection.engee,而不是分析计算。 让我们启动应用程序。 档案 start.jl 连接控制函数,打开模型并调用 engee.genie.start.
include(joinpath(resources_dir, "julia", "start.jl"))
app_url = match(r"https://[^\s']+?/genie/CRCApp/", repr(crc_app_status))
println("应用程序正在运行: ", isnothing(app_url) ? crc_app_status : app_url.match)
单元格在窗体中显示应用程序的地址 https://engee.com/prod/user/<имя_пользователя>/genie/CRCApp/. 在浏览器中打开它。 这就是体验参数的形式。:
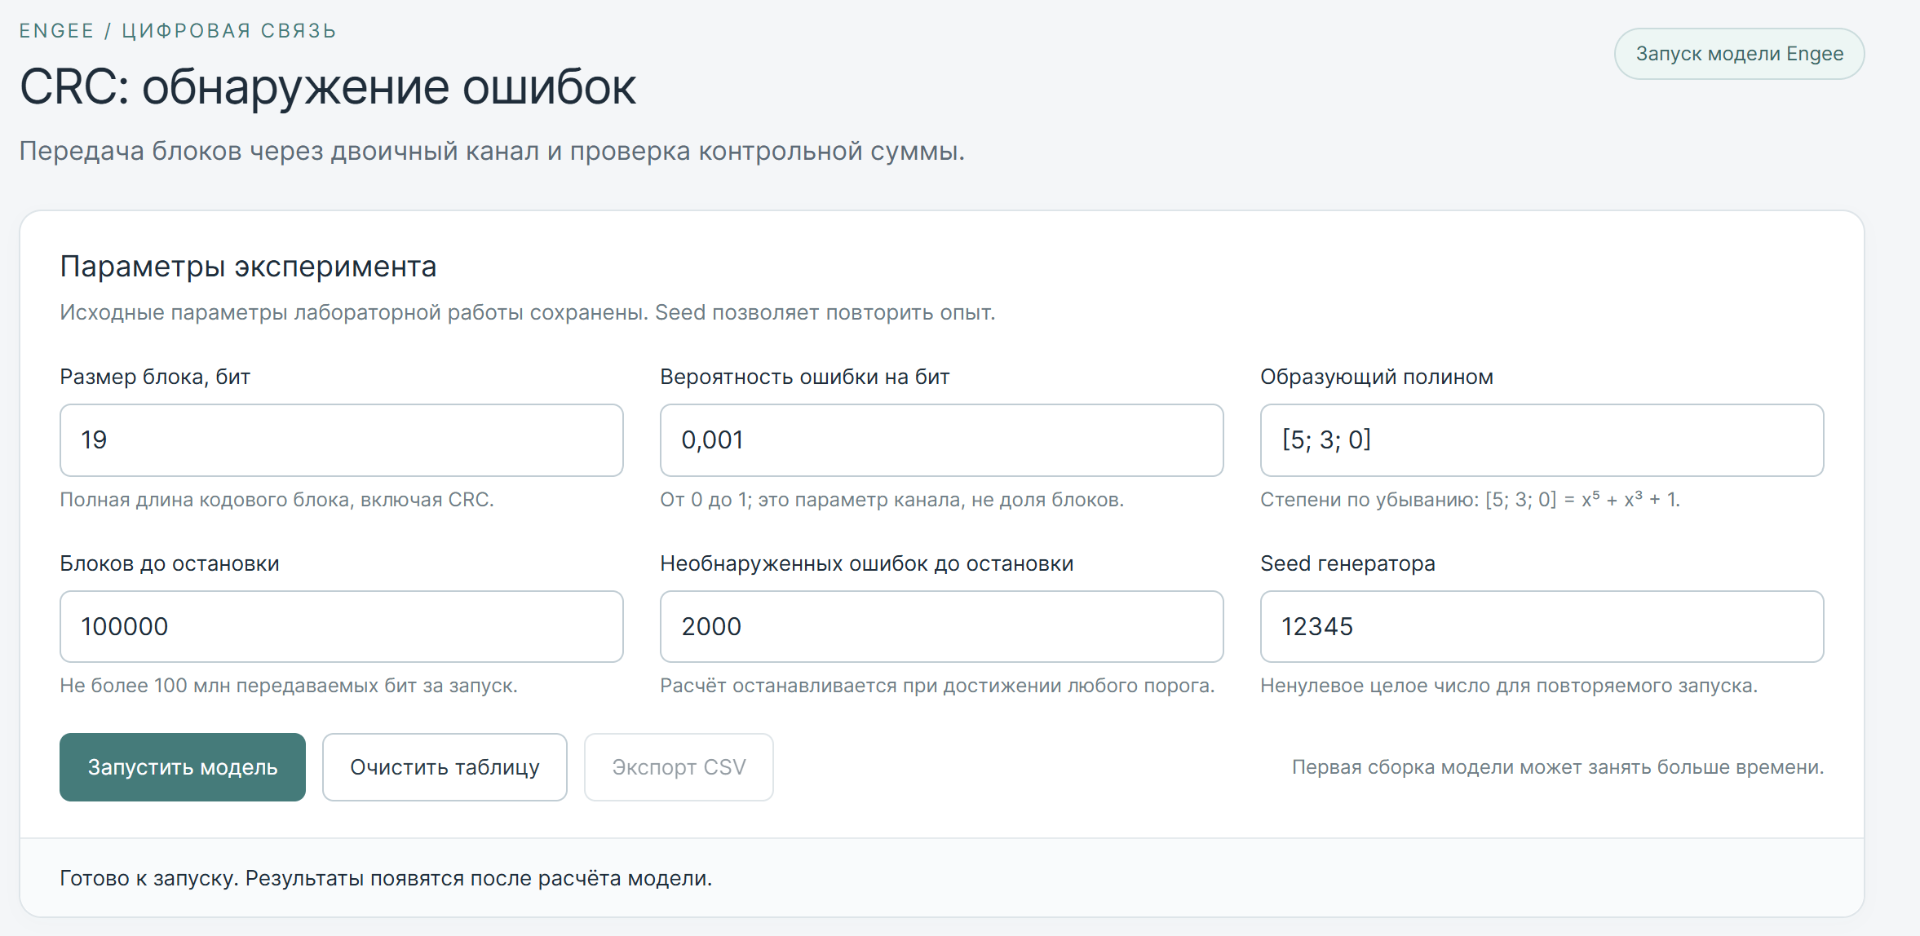
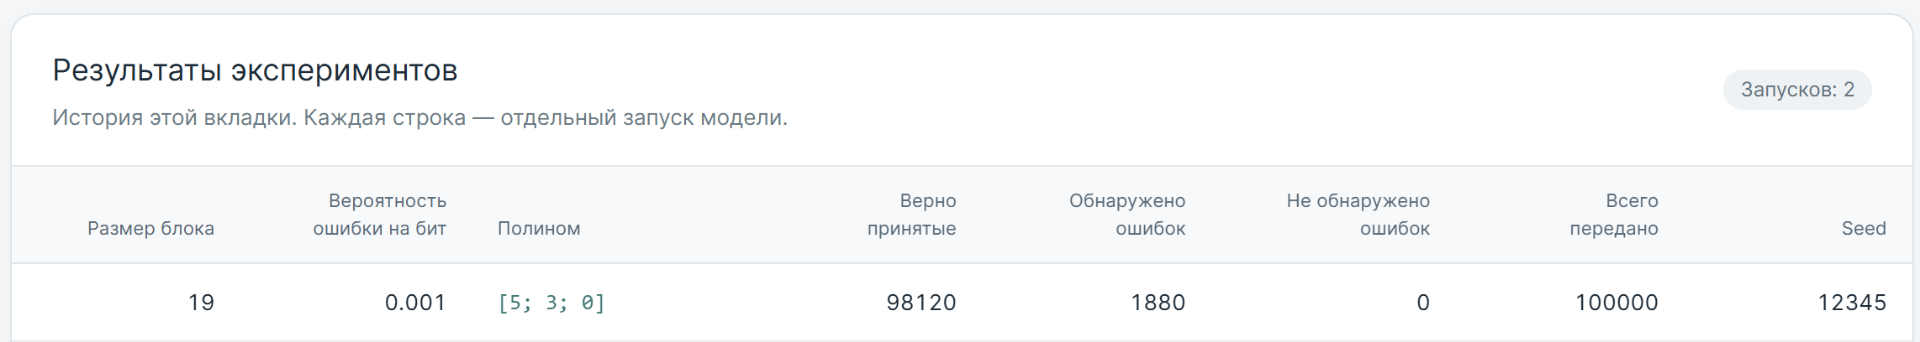
启动模型后,结果将显示在表格中。 下图显示了初始参数的体验。: 包裹在 . 正确包的百分比 与理论上的不谋而合 . 启动后,模型将保持打开状态,以便在脚本和应用程序中进行进一步的实验。
最后一个单元格返回该点的摘要 .
th = theory(0.1); r = sim[0.1]
string("CRC ok; p=0.1: correct=", round(r.correct / r.packets, digits = 4), " (theory ", round(th.correct, digits = 4),
       "), undetected=", round(r.undetected / r.packets, sigdigits = 3), " (theory ", round(th.undetected, sigdigits = 3), ")")
结论
我们研究了使用CRC对库块的AnyMath模型进行错误检测,并将仿真结果与精确理论进行了比较。 具有多项式的代码 和包装的长度 该位保证检测单和双错误,因为它的最小重量是 ,以及长度最大的错误数据包 比特。 在整个范围内,正确的、检测到的和未检测到的包装的比例与从代码的权重谱计算出的理论相吻合 从 以前 . 由 CRC跳过 数据包,但在一个完全嘈杂的信道 — . 丢失错误的概率由多项式的程度决定 及其权谱,因此,在可靠的系统中使用更高程度的多项式。
这种方法--模型、软件检查、与理论的比较以及交互式应用--对于实验室工作和错误检测系统的工程评估非常有用。