优化员工之间的办公空间分配
导言
这个例子提出了一个解决问题的最佳分配有限的资源—办公空间—员工之间,考虑到一些组织的要求。 优化标准是员工的个人偏好,由他们的服务时间加权,以及两对从事联合项目的员工的工作邻接的先决条件。 该任务以整数线性规划模型的形式形式化,以便在观察所有既定约束的同时最大化偏好的总加权满意度。
楼宇分布
我们的任务是在六名员工中分配七个办公空间。
员工的名字是:Anna,Artyom,Alyona,Anton,Andrey,Anastasia。
每个员工得到一个办公室,每个办公室不能超过一个人。 因此,一个房间将不可避免地保持空。
员工可以表明他们选择工作的偏好,这些愿望是根据他们在公司的工作经验考虑的:一个人在公司工作的时间越长,他们的优先级就越高。
房间的布局是异质的:有些办公室有窗户,有些没有窗户,其中一个窗户明显小于其他窗户。 另一个复杂的问题是,Alyona和Anton经常成对工作,所以他们应该被放置在相邻的房间。 这同样适用于安德烈和阿纳斯塔西娅—他们的工作也应该是相邻的。
我们将添加必要的库和布局功能。
import Pkg
Pkg.add(["JuMP", "HiGHS"])
using JuMP, HiGHS, LinearAlgebra
include("officeassign.jl")
楼宇的布局
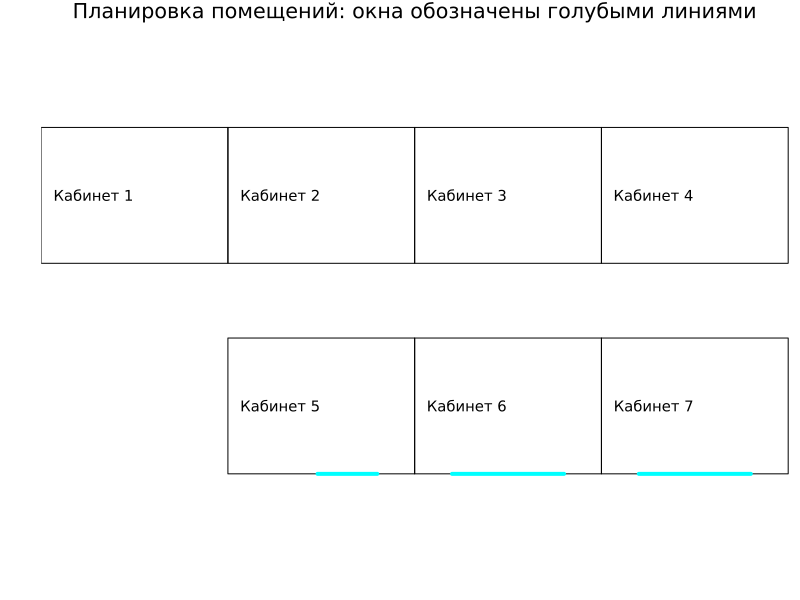
办公室1,2,3和4位于大楼内-这些都是没有窗户的房间。 房间5,6和7有机会获得自然光,但重要的是要注意,在房间5的窗口比其他两个显着小。
办公室的布局:
кабинеты = ["Кабинет 1", "Кабинет 2", "Кабинет 3", "Кабинет 4", "Кабинет 5", "Кабинет 6", "Кабинет 7"];
officeassign(кабинеты)
设置任务
让我们将问题呈现为数学模型。 让我们创建二进制变量,以指示办公室是否属于特定员工。
雇员名单:
имена = ["Анна", "Артём", "Алёна", "Антон", "Андрей", "Анастасия"];
让我们创建由办公室号码和员工姓名索引的二进制变量。
модель = Model(HiGHS.Optimizer)
@variable(модель, занимает[i in имена, j in кабинеты],
          Int, lower_bound=0, upper_bound=1);
员工经验
有必要根据员工的服务年限为员工偏好分配权重因子。 因此,一个人在MathWorks工作的时间越长,他们的愿望就越重要。
员工的服务年限分布如下:
*安娜9岁
*Artyom—2岁
*Alyona-5岁
*安东—4岁
*安德烈-1.5岁
*阿纳斯塔西娅10岁
基于这些数据,需要构造加权系数的归一化向量。
стаж = [9, 2, 5, 4, 1.5, 10];
весовой_вектор = стаж/sum(стаж);
员工偏好
让我们构建一个偏好矩阵,其中行对应于办公室,列对应于员工。 每个人都应该被要求对每个办公室进行评分,以便他们所有等级的总和(即列的总和)为100。 价值越高,这个办公室对员工来说就越理想。 每个人的偏好被表示为一个向量列。
Анна = [1, 3, 3, 3, 10, 40, 40];
Артём = [0, 0, 0, 0, 20, 40, 40];
Алёна = [0, 0, 0, 0, 30, 40, 30];
Антон = [0, 0, 0, 10, 10, 40, 50]
Андрей = [3, 4, 1, 2, 10, 40, 40];
Анастасия = [10, 10, 10, 10, 20, 20, 20];
每个员工的偏好向量的每个第i个元素显示了他们对第i个办公室的重视程度。
因此,最终的偏好矩阵如下所示:
матрица_предпочтений = [Анна Артём Алёна Антон Андрей Анастасия]';
将偏好矩阵乘以权重向量,以根据年资缩放列。
ПМ = zeros(length(имена), length(кабинеты))
for i in 1:length(имена)
    for j in 1:length(кабинеты)
        ПМ[i, j] = весовой_вектор[i] * матрица_предпочтений[i, j]
    end
end
目标功能
这项任务的目标是根据员工的资历最大限度地提高员工的满意度。 现在,您需要创建一个优化任务,并在其中包含此目标函数。
@objective(модель, Max, sum(занимает[i, j] * ПМ[findfirst(isequal(i), имена), findfirst(isequal(j), кабинеты)]
                          for i in имена, j in кабинеты));
限制
第一个条件确保每个员工得到一个办公室。 在数学上,这意味着对于每个人来说,变量的值之和是 занимает 它必须完全等于所有办公室的一个。
@constraint(модель, ограничение1[i in имена], sum(занимает[i, j] for j in кабинеты) == 1);
第二组条件由不等式表示。 这些限制确保每个办公室不超过一人。
@constraint(модель, ограничение2[j in кабинеты], sum(занимает[i, j] for i in имена) <= 1);
要求Alyona和Anton位于办公室,之间的距离不超过一个办公室。 类似的情况适用于阿纳斯塔西娅和安德烈。
我们将设置限制,以确保阿廖娜和安东将不超过一个办公室远离对方。
@constraint(модель, ограничение_Алёна_Антон_1, занимает["Алёна","Кабинет 1"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 2"] <= 1);
@constraint(модель, ограничение_Алёна_Антон_2, занимает["Алёна","Кабинет 2"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 1"] - занимает["Антон","Кабинет 3"] - занимает["Антон","Кабинет 5"] <= 1);
@constraint(модель, ограничение_Алёна_Антон_3, занимает["Алёна","Кабинет 3"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 2"] - занимает["Антон","Кабинет 4"] - занимает["Антон","Кабинет 6"] <= 1);
@constraint(модель, ограничение_Алёна_Антон_4, занимает["Алёна","Кабинет 4"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 3"] - занимает["Антон","Кабинет 7"] <= 1);
@constraint(модель, ограничение_Алёна_Антон_5, занимает["Алёна","Кабинет 5"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 2"] - занимает["Антон","Кабинет 6"] <= 1);
@constraint(модель, ограничение_Алёна_Антон_6, занимает["Алёна","Кабинет 6"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 3"] - занимает["Антон","Кабинет 5"] - занимает["Антон","Кабинет 7"] <= 1);
@constraint(модель, ограничение_Алёна_Антон_7, занимает["Алёна","Кабинет 7"] + sum(занимает["Антон", j] for j in кабинеты) - занимает["Антон","Кабинет 4"] - занимает["Антон","Кабинет 6"] <= 1);
现在,我们将设置限制,以确保阿纳斯塔西娅和安德烈将不超过一个办公室远离对方。
@constraint(модель, ограничение_Андрей_Анастасия_1, занимает["Андрей","Кабинет 1"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 2"] <= 1);
@constraint(модель, ограничение_Андрей_Анастасия_2, занимает["Андрей","Кабинет 2"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 1"] - занимает["Анастасия","Кабинет 3"] - занимает["Анастасия","Кабинет 5"] <= 1);
@constraint(модель, ограничение_Андрей_Анастасия_3, занимает["Андрей","Кабинет 3"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 2"] - занимает["Анастасия","Кабинет 4"] - занимает["Анастасия","Кабинет 6"] <= 1);
@constraint(модель, ограничение_Андрей_Анастасия_4, занимает["Андрей","Кабинет 4"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 3"] - занимает["Анастасия","Кабинет 7"] <= 1);
@constraint(модель, ограничение_Андрей_Анастасия_5, занимает["Андрей","Кабинет 5"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 2"] - занимает["Анастасия","Кабинет 6"] <= 1);
@constraint(модель, ограничение_Андрей_Анастасия_6, занимает["Андрей","Кабинет 6"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 3"] - занимает["Анастасия","Кабинет 5"] - занимает["Анастасия","Кабинет 7"] <= 1);
@constraint(модель, ограничение_Андрей_Анастасия_7, занимает["Андрей","Кабинет 7"] + sum(занимает["Анастасия", j] for j in кабинеты) - занимает["Анастасия","Кабинет 4"] - занимает["Анастасия","Кабинет 6"] <= 1);
决定
我们来解决优化问题。
optimize!(модель);
решение = value.(занимает);
значение_функции = objective_value(модель);
статус_выхода = termination_status(модель);
выходные_данные = raw_status(модель);
解决方案的可视化
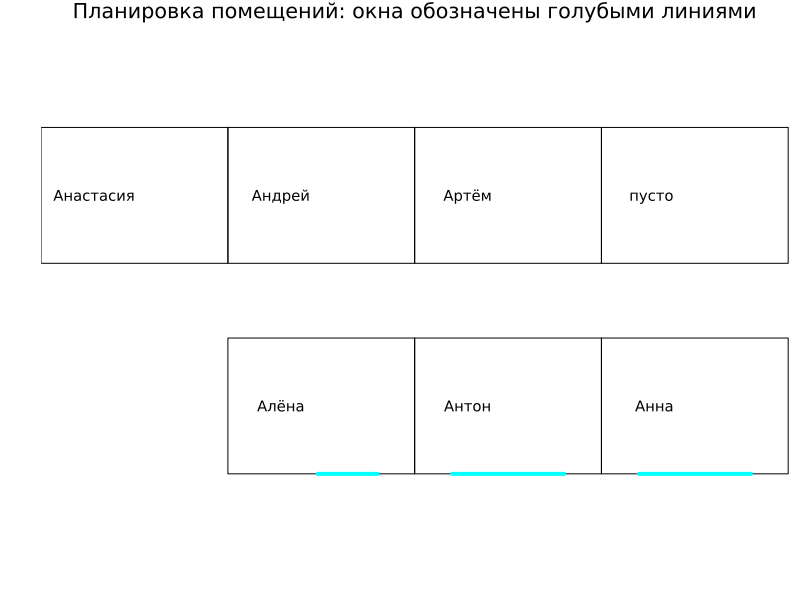
我们将办公空间在员工之间的最佳分布可视化。
число_кабинетов = length(кабинеты);
кабинет = Vector{Vector{String}}(undef, число_кабинетов);
for i=1:число_кабинетов
    кабинет[i] = имена[findall(x -> x > 0.5, [решение[имя, кабинеты[i]] for имя in имена])]
end

кто_в_кабинете = copy(кабинеты);
for i=1:число_кабинетов
    if isempty(кабинет[i])
        кто_в_кабинете[i] = " пусто  ";
    else
        кто_в_кабинете[i] = кабинет[i][1];
    end
end

officeassign(кто_в_кабинете);
значение_функции,статус_выхода,выходные_данные
结论
作为求解优化问题的结果,获得了在充分观察指定条件的同时确保目标函数的最大值的柜分布。 该解决方案展示了应用数学建模方法在标准冲突和资源有限的情况下做出客观管理决策的有效性。 所使用的方法使得能够正式化和平衡主观的人类偏好和严格的操作要求。