Оптимальное управление спутниками с применением уравнений Рикатти
Спутник на орбите постоянно отклоняется от расчетной траектории: гравитация Земли неоднородна, Солнце и Луна тянут в разные стороны, двигатели работают с погрешностью.
Задача системы управления — удерживать аппарат на опорной орбите, минимизируя расход топлива. Топливо — это масса, масса — это срок жизни. Поэтому вопрос «как тратить меньше, но держать точнее» превращается в задачу оптимального управления.
Уравнение Риккати — математический мост между «хочу стабилизировать систему» и «хочу делать это с минимальными затратами». Оно даёт закон управления с обратной связью вида u = −Kx, где матрица усиления K вычисляется из решения уравнения Риккати. При этом не нужно вручную подбирать коэффициенты ПИД-регулятора — они получаются автоматически и являются оптимальными для выбранных весов.
Мы рассмотрим три задачи:
- Удержание на круговой орбите — классический LQR, матрицы A и B постоянны, уравнение Риккати решается один раз.
- Удержание на гало-орбите около точки L1 — матрицы A(t) и B(t) периодически зависят от времени, и уравнение Риккати нужно решать для каждого момента витка.
- Удержание при нелинейной динамике — SDRE: уравнение Риккати в контуре управления.
Задача 1. Удержание на круговой орбите (LQR)
Что решаем. Спутник должен оставаться в окрестности круговой орбиты радиуса r. Модель относительного движения в орбитальной системе координат (уравнения Клохесси–Уилтшира) линеаризуется в виде:
где x = [δx, δy, δz, δẋ, δẏ, δż]ᵀ — отклонения по положению и скорости от опорной орбиты, u = [uₓ, u_y, u_z]ᵀ — ускорения от двигателей.
Матрицы и их смысл:
A— матрица динамики (6×6), содержит гравитационные члены и кориолисовы ускорения;B— матрица управления (6×3), показывает, как тяга влияет на скорости;Q— штраф за отклонение (6×6), чем больше элементQ[i,i], тем сильнее мы наказываем за отклонение по i-й координате;R— штраф за расход топлива (3×3), чем большеR, тем экономнее управление;P— решение уравнения Риккати (6×6), симметричная положительно-определённая матрица;K = R⁻¹BᵀP— оптимальный коэффициент усиления, который мы подаём в закон u = −Kx.
Установим библиотеки, которых может не быть в вашей системе:
Pkg.add(["ControlSystems", "DifferentialEquations"])
gr()
using ControlSystems, LinearAlgebra

# --- Параметры орбиты ---
μ  = 3.986e5       # гравитационный параметр Земли, км³/с²
r  = 6771.0        # радиус орбиты, км
n  = sqrt(μ/r^3)   # средняя угловая скорость, рад/с

# --- Матрицы Клохесси–Уилтшира (линеаризация относительного движения) ---
A = [0 0 0  1 0 0;
     0 0 0  0 1 0;
     0 0 0  0 0 1;
     3n^2 0 0  0 2n 0;
     0 0 0  -2n 0 0;
     0 0 -n^2 0 0 0]

B = [0 0 0; 0 0 0; 0 0 0; 1 0 0; 0 1 0; 0 0 1]

# --- Веса: Q наказывает отклонение по положению сильнее, чем по скорости ---
#Q = diagm([1.0, 1.0, 1.0, 0.1, 0.1, 0.1])
#R = 100.0 * I(3)   # дорогое топливо → экономное управление

Q = diagm([0.01, 0.01, 0.01, 0.1, 0.1, 0.1])   # слабый штраф за положение
R = 1e4 * I(3)                                  # дорогое топливо

# --- Решаем уравнение Риккати и получаем K ---
P = care(A, B, Q, R)
K = inv(R) * B' * P

println("Оптимальный коэффициент усиления K:")
display(round.(K, digits=3))
println("\nСобственные числа замкнутой системы (должны быть в левой полуплоскости):")
display(round.(eigvals(A - B*K), digits=4))
Визуализация. Запустим симуляцию с начальным отклонением по оси X и посмотрим, как спутник возвращается к опорной орбите.
# --- Симуляция замкнутой системы с возмущением ---
x0 = [5.0, 0.0, 0.0, 0.0, 0.0, 0.0]
t  = range(0, stop=4000.0, length=2000)

# Открытая система: только физика, без регулятора
sys_open = ss(A, B, Matrix(1.0I,6,6), zeros(6,3))

# Возмущение: постоянное ускорение вдоль орбиты (порядок J2)
d_along(t) = 1e-3                       # км/с²
# и слабая синусоида по радиали для наглядности
d_rad(t)   = 3e-4 * sin(2π * t / 5400)
# Масштабы возмущения на пару порядков больше обычных для визуализации

# Закон управления + возмущение, действующее на входе объекта
# (регулятор «видит» только x, возмущение добавляем как внешний вход)
function u_fb(x, t)
    return -K*x .+ [d_along(t), d_rad(t), 0.0]
end

res = lsim(sys_open, u_fb, t, x0=x0)
x      = res.x        # 6×2000
t_out  = res.t

# --- Управление, которое реально выдаёт регулятор (без возмущения) ---
u = -K * x
u_norm_mm = [norm(u[:, i]) for i in 1:size(u, 2)] .* 1e3

# --- График ---
p1 = plot(t_out, x[1,:], label="δx (вдоль орбиты)", lw=2,
          xlabel="время, с", ylabel="км", title="Отклонение от опорной орбиты (с возмущением)")
plot!(p1, t_out, x[2,:], label="δy (радиальное)", lw=2)
plot!(p1, t_out, x[3,:], label="δz (боковое)", lw=2)

p2 = plot(t_out, u_norm_mm, lw=2, color=:red, legend=false,
          xlabel="время, с", ylabel="мм/с²", title="Расход управления ‖u‖")

plot(p1, p2, layout=(2,1), size=(800,600))
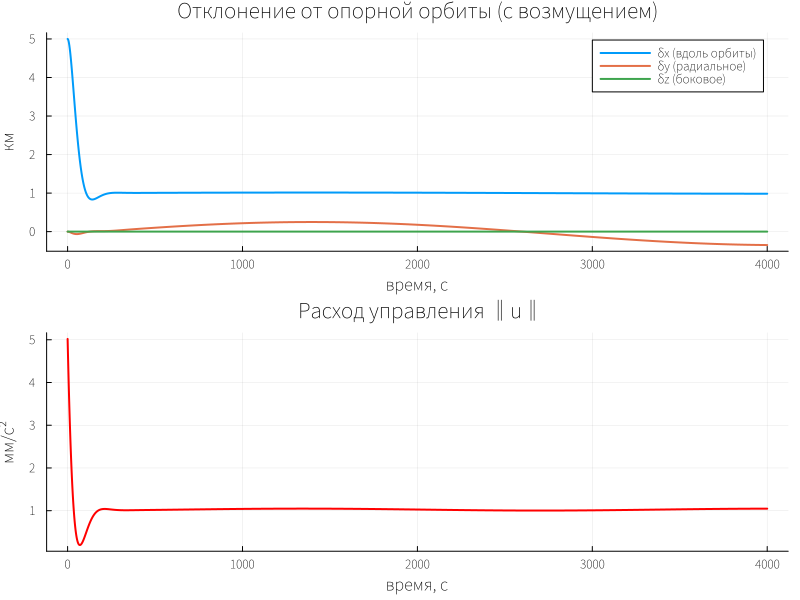
Что видим. Постоянная матрица K обеспечивает плавное возвращение к нулю за несколько тысяч секунд. Управление в начале максимально (нужно погасить отклонение), затем стремится к нулю. Это и есть оптимальный баланс между точностью и топливом — ровно тот, что задан весами Q и R.
Задача 2. Удержание на гало-орбите около L1 (периодическая система)
Что решаем. В окрестности точки Лагранжа L1 (система Солнце–Земля) существуют гало-орбиты — периодические траектории с периодом порядка полугода. Здесь матрицы A(t) и B(t) периодически меняются во времени, потому что линеаризация проводится в каждой точке витка. Уравнение Риккати становится дифференциальным:
Что это меняет на практике. Вместо одного вызова care мы решаем обратную задачу: интегрируем уравнение Риккати назад по времени на одном периоде и получаем периодическое решение P(t). Из него строится K(t) = R⁻¹B(t)ᵀP(t), и управление u(t) = −K(t)x(t) учитывает, в какой фазе витка находится аппарат.
Смысл переменных:
A(t),B(t)— линеаризованные матрицы в текущей точке гало-орбиты (зависят от фазы витка);P(t)— решение DRE, уже не константа, а функция времени;K(t)— периодический коэффициент усиления;- интегрирование ведётся в обратном времени от
t = Tдоt = 0, потому что DRE для стабилизирующего решения — это краевая задача (граничное условиеP(T) = P(0)).
Лаконичная реализация идеи. Для демонстрации используем простую модель Хилла с модуляцией n(t) = n₀(1 + ε·cos(2πt/T)) — это грубая, но наглядная имитация периодичности:
using DifferentialEquations

T_period = 1.0                      # нормированный период витка
ε = 0.3                             # амплитуда модуляции

# --- Периодические матрицы A(t), B(t) ---
function A_t(t)
    n_t = 1.0 * (1 + ε*cos(2π*t/T_period))
    return [0 0 0  1 0 0;
            0 0 0  0 1 0;
            0 0 0  0 0 1;
            3n_t^2 0 0  0 2n_t 0;
            0 0 0  -2n_t 0 0;
            0 0 -n_t^2 0 0 0]
end
B_t(t) = [0 0 0; 0 0 0; 0 0 0; 1 0 0; 0 1 0; 0 0 1]

Q = diagm([1.0, 1.0, 1.0, 0.1, 0.1, 0.1])
R = 100.0 * I(3)

# --- DRE в обратном времени: dP/dt = -(AᵀP + PA - PBR⁻¹BᵀP + Q) ---
function dre!(dP, P, p, t)
    P = reshape(P, 6, 6)
    At, Bt = A_t(t), B_t(t)
    dP_mat = -(At'P + P*At - P*Bt*inv(R)*Bt'*P + Q)
    dP .= vec(dP_mat)
end

# Начальное приближение: стационарное решение при t=0
P0 = care(A_t(0), B_t(0), Q, R)
prob = ODEProblem(dre!, vec(P0), (T_period, 0.0))   # интегрируем назад: (T, 0)
sol = solve(prob, Tsit5(), saveat=range(T_period, 0.0, length=200))

# --- Визуализация: как K(t) меняется вдоль витка ---
K_norm = [norm(inv(R)*B_t(t)'*reshape(sol(t),6,6)) for t in range(0, T_period, length=200)]
plot(range(0, T_period, length=200), K_norm, lw=2,
     xlabel="фаза витка (нормированная)", ylabel="‖K(t)‖",
     title="Периодический коэффициент усиления на гало-орбите")
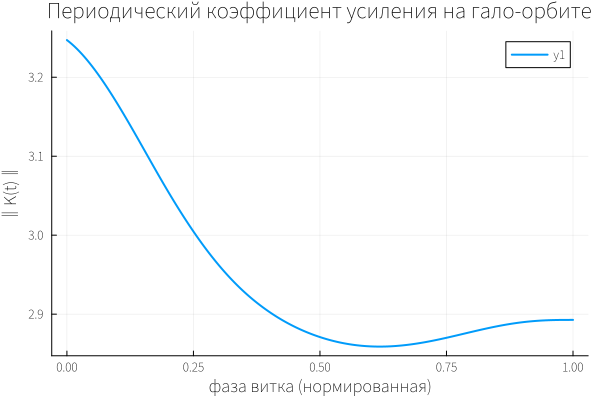
Что видим. Норма ‖K(t)‖ не постоянна: она «дышит» вместе с фазой витка. В той части орбиты, где динамика более чувствительна к возмущениям, контроллер становится жёстче; там, где аппарат движется «спокойно», — мягче. Это и есть преимущество периодического подхода: мы не тратим топливо на избыточное управление в «лёгких» фазах витка.
Задача 3. Нелинейная динамика (SDRE)
В первых двух примерах мы использовали фиксированные матрицы A и B: считали, что динамика спутника не зависит от того, где он находится. Для малых отклонений от круговой орбиты это разумно. Но как только аппарат уходит далеко от опорной точки — например, на эллиптической орбите или при переходе между орбитами — матрицы линеаризации начинают зависеть от текущего состояния: A(x), B(x). Здесь на смену обычному LQR приходит SDRE (State-Dependent Riccati Equation): уравнение Риккати решается заново на каждом шаге, с актуальными матрицами, и коэффициент усиления K(x) подстраивается под режим движения.
Сделаем третий сценарий: тот же спутник, та же цель — удержать его около опорной орбиты, но теперь A и B пересчитываются в каждой точке траектории. Посмотрим, как ведёт себя ‖K(t)‖ и что это даёт по сравнению с фиксированным K.
using ControlSystems, LinearAlgebra

# --- Параметры ---
μ  = 3.986e5
r0 = 6771.0
n0 = sqrt(μ/r0^3)

# --- Построение A(x), B(x): линеаризация зависит от текущего радиуса ---
# Используем модель Клохесси–Уилтшира, но с n(x) = sqrt(μ/r(x)^3),
# где r(x) = r0 + δy (радиальное отклонение)
function build_AB(x)
    r  = r0 + x[2]                 # текущий радиус: опорный + радиальное отклонение
    n  = sqrt(μ / r^3)             # локальная угловая скорость
    A  = [0 0 0  1 0 0;
          0 0 0  0 1 0;
          0 0 0  0 0 1;
          3n^2 0 0  0 2n 0;
          0 0 0  -2n 0 0;
          0 0 -n^2 0 0 0]
    B  = [0 0 0; 0 0 0; 0 0 0; 1 0 0; 0 1 0; 0 0 1]
    return A, B
end

# --- Веса ---
Q = diagm([1.0, 1.0, 1.0, 0.1, 0.1, 0.1]) ./ 10
R = 100.0 * I(3) .* 10
# Множитель 10 введен для более наглядной визуализации

# --- SDRE-симуляция: care на каждом шаге ---
x0    = [5.0, 0.0, 0.0, 0.0, 0.0, 0.0]
t_end = 4000.0
dt    = 1.0
t_grid = 0.0:dt:t_end

x = copy(x0)
xs = zeros(6, length(t_grid))
Ks = zeros(length(t_grid))
us = zeros(3, length(t_grid))

for (i, t) in enumerate(t_grid)
    A_t, B_t = build_AB(x)
    P = care(A_t, B_t, Q, R)           # уравнение Риккати на текущем шаге
    K = inv(R) * B_t' * P
    u = -K * x
    xs[:, i] = x
    Ks[i]    = norm(K)
    us[:, i] = u
    # Шаг интегрирования (явный Эйлер; для статьи достаточно)
    x = x + dt * (A_t * x + B_t * u)
end

# --- Для сравнения: фиксированный K из опорной точки ---
A0, B0 = build_AB(x0)
K_fix  = inv(R) * B0' * care(A0, B0, Q, R)

x_fix = copy(x0)
xs_fix = zeros(6, length(t_grid))
for (i, t) in enumerate(t_grid)
    A_t, B_t = build_AB(x_fix)
    u = -K_fix * x_fix
    xs_fix[:, i] = x_fix
    x_fix = x_fix + dt * (A_t * x_fix + B_t * u)
end
Мы ожидаем, что норма‖K(t)‖ не будет постоянной: по мере того как спутник отклоняется по радиусу, локальная угловая скорость n(x) меняется, матрица A(x) «дышит», и SDRE-регулятор подстраивает усиление. Там, где динамика более чувствительна, K становится жёстче; там, где спокойнее — мягче.
Кроме того, мы ожидаем, что SDRE и фиксированный K дадут близкие траектории при малых отклонениях (потому что n(x) ≈ n0), но SDRE будет чуть точнее удерживать ноль, поскольку он «знает» о текущем радиусе. Разница должна быть небольшой — и это тоже важный вывод: для малых отклонений SDRE не панацея, а для больших — необходимость.
p1 = plot(t_grid, Ks, lw=2, color=:blue,
          xlabel="время, с", ylabel="‖K(t)‖",
          title="SDRE: коэффициент усиления пересчитывается на каждом шаге")
hline!(p1, [norm(K_fix)], ls=:dash, color=:gray, label="‖K‖ фиксированный")

p2 = plot(t_grid, xs[2,:], label="SDRE", lw=2,
          xlabel="время, с", ylabel="δy, км",
          title="Радиальное отклонение: SDRE vs фиксированный K")
plot!(p2, t_grid, xs_fix[2,:], label="фиксированный K", lw=2, ls=:dash)

p3 = plot(t_grid, [norm(us[:,i]) for i in 1:length(t_grid)] .* 1e3,
          lw=2, color=:red, legend=false,
          xlabel="время, с", ylabel="мм/с²", title="Расход управления (SDRE)")

plot(p1, p2, p3, layout=(3,1), size=(800,900))
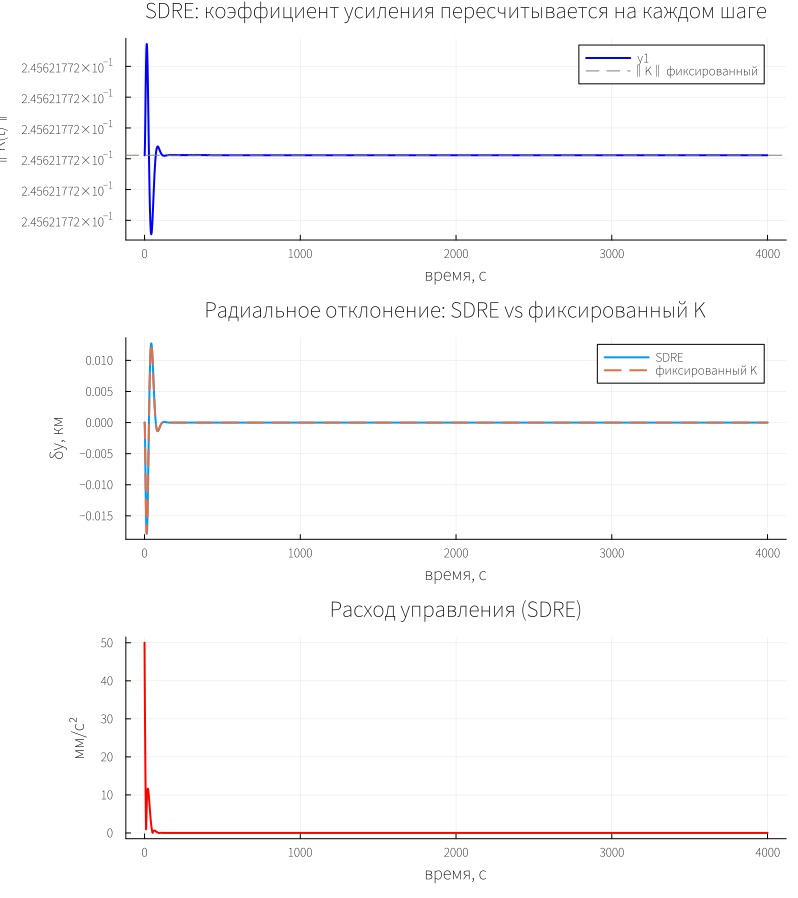
Что видим: На первом графике ‖K(t)‖ действительно меняется вдоль траектории: в начале, пока отклонение велико, регулятор жёстче; по мере выхода на опорную орбиту ‖K‖ приближается к значению, соответствующему n0. Пунктирная линия фиксированного K лежит внутри этого диапазона — SDRE «обнимает» её сверху и снизу.
На втором графике траектории почти совпадают: при отклонении 5 км разница между SDRE и фиксированным K невелика. Это ожидаемо — n(x) меняется слабо, пока δy ≪ r0. Но если увеличить начальное отклонение до десятков километров, SDRE начнёт заметно выигрывать: фиксированный K рассчитан на «неправильную» угловую скорость и либо перерегулирует, либо недорегулирует.
На третьем графике видно, что расход управления в SDRE плавно спадает — регулятор не «дёргается» при пересчёте K, потому что матрицы меняются непрерывно вместе с состоянием.
На практике care на каждом шаге для бортового компьютера может быть дорогим, поэтому в реальных миссиях используют аппроксимации: θ-D метод, разложение в ряд по малому параметру, нейросетевые суррогаты решения уравнения Риккати или предвычисленные таблицы K(x) для характерных режимов — всё это сохраняет идею SDRE, но убирает необходимость решать уравнение Риккати в реальном времени.
Выводы
Все три задачи решают одну и ту же инженерную проблему — удержать спутник там, где он нужен, потратив минимум топлива — но с разным уровнем детализации модели.
Уравнение Риккати даёт формальный ответ на вопрос «как», а матрицы Q и R — на вопрос «какой ценой». Меняя их, инженер управляет компромиссом между точностью и ресурсом, не переписывая закон управления. В контуре SDRE оно работает как вычислительное ядро, которое на каждом шаге выдаёт актуальный K(x), и это позволяет регулятору оставаться оптимальным там, где фиксированные матрицы уже не описывают динамику.